IVF-Datenqualitätsmetriken: Warum Ihre Konvertierungs-KPIs eine Vertrauensebene benötigen
IVF-Analysen auf Entscheidungsebene erfordern eine Vertrauensebene, die Konversions-KPIs mit spezifischen Datenqualitätsmetriken kombiniert, um sicherzustellen, dass das zugrunde liegende Modell für operative Entscheidungen zuverlässig ist. Dieses Framework stützt sich auf die Überwachung von Mapping-Abdeckungsraten, um eine Verzerrung des Nenners zu verhindern, sowie auf die Verfolgung der Statusaktualität, um sicherzustellen, dass Pipeline-Entscheidungen auf dem aktuellen Patientenfortschritt und nicht auf veralteten Informationen basieren.
#4 | Irresist IVF Insights
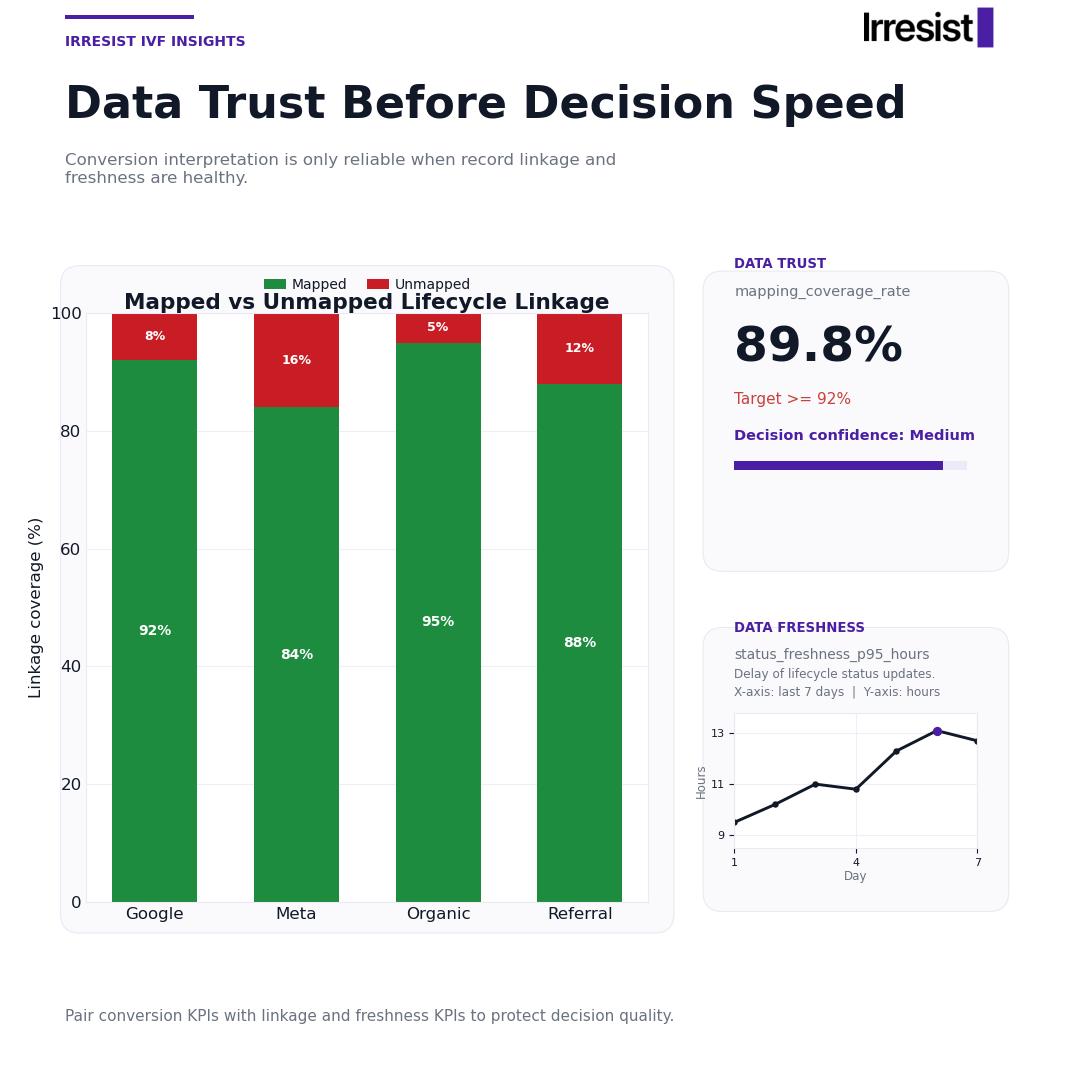
Stellen Sie sich ein Klinik-Dashboard vor, auf dem die Lead-zu-Patienten-Konvertierung in jedem Kanal stark aussieht. Budgets werden genehmigt, die Personalplanung bleibt unverändert und die Geschäftsführung geht zum nächsten Tagesordnungspunkt über. Nur wurden 16 % der Meta-Leads nie mit einem nachgelagerten Lifecycle-Status verknüpft, sodass die Konvertierungsrate, auf deren Basis gerade gehandelt wurde, gegen einen unvollständigen Nenner berechnet wurde. Niemand im Raum hatte eine Möglichkeit, das zu wissen.
Dies ist das Kernproblem bei IVF-Datenqualitätsmetriken, denen eine Vertrauensebene fehlt. Budget- und Personalentscheidungen werden auf Basis von Konvertierungsraten getroffen, die niemand tatsächlich verifizieren kann. Die Zahlen fühlen sich präzise an, weil sie mit Dezimalstellen und Trendlinien dargestellt werden, aber Präzision und Zuverlässigkeit sind nicht dasselbe.
Konvertierungs-KPIs und Datenvertrauens-KPIs sind keine getrennten Kategorien. Sie müssen zusammen gelesen werden, sonst wird die Konvertierungszahl richtungsweisend unzuverlässig. Dieser Artikel befasst sich mit zwei Vertrauensmetriken: mapping_coverage_rate und status_freshness_p95_hours. Zusammen ziehen sie die Linie zwischen Analytics für Präsentationszwecke und Analytics für Entscheidungsprozesse. Diese Linie hat nichts mit visuellem Design zu tun, sondern alles damit, ob dem Datenmodell bei Betriebsgeschwindigkeit vertraut werden kann.
Wichtige Erkenntnisse
Mapping-Abdeckungsrate (Mapping coverage rate) – Der Anteil der Lead-Datensätze, die erfolgreich mit nachgelagerten Lifecycle-Status verknüpft wurden. Wenn die Abdeckung schwach ist, ist Ihr Konvertierungs-Nenner falsch und die Performance sieht besser aus als in der Realität.
Status-Aktualität ist kanalabhängig – Verschiedene Quellen können stark unterschiedliche Abdeckungsraten aufweisen. Das bedeutet, dass ein Vergleich von Kanälen ohne Prüfung der Verknüpfungsqualität strukturell ungültig ist.
Veraltete Lifecycle-Daten verzerren Entscheidungen – Wenn
status_freshness_p95_hours48 Stunden überschreitet, treffen Sie möglicherweise Personal- und Aufnahmeentscheidungen auf Basis von Pipeline-Daten, die nicht mehr der Realität entsprechen.Entscheidungsrelevante Analytics erfordern Vertrauenskontrollen – Eine Vertrauensebene koppelt jeden Konvertierungs-KPI mit einem Schwellenwert, einem Verantwortlichen und einer dokumentierten Maßnahme bei Abweichungen.
Dies ist Governance, kein Engineering – Die Implementierung einer Vertrauensebene bedeutet, Verantwortliche zu benennen und Schwellenwerte festzulegen, nicht den gesamten Daten-Stack neu aufzubauen.
Warum Mapping-Qualität die Bedeutung von Konvertierungszahlen verändert
Akquisitionsdaten (Leads, Kanäle, Quellen) befinden sich normalerweise in einem System. Daten zum Lifecycle-Verlauf (became_patient, service_started) befinden sich im CRM oder EMR. Der Konvertierungs-KPI hängt von der Zusammenführung dieser beiden Welten ab. Wenn diese Zusammenführung für eine Teilmenge von Datensätzen fehlschlägt, werden diese Datensätze für Konvertierungsberechnungen unsichtbar.
Ein zugeordneter (mapped) Datensatz ist ein Datensatz, der erfolgreich mit einem nachgelagerten Lifecycle-Status verknüpft wurde. Ein nicht zugeordneter Datensatz konnte nicht zuverlässig verknüpft werden und verschwindet einfach aus dem Modell. Die Metrik, die dies erfasst, ist die mapping_coverage_rate: zugeordnete Datensätze geteilt durch die Gesamtzahl der relevanten Datensätze.
Die Verzerrung ist strukturell. Wenn 16 % der Meta-Leads nicht zugeordnet sind, wird die Lead-zu-Patient-Rate für Meta auf Basis von 84 % der tatsächlichen Leads berechnet. Der Nenner schrumpft, und die Konvertierungsrate erscheint gesünder, als sie ist. Schlimmer noch: Dieses Problem variiert je nach Quelle, was bedeutet, dass Lücken in der CRM/EMR-Datenverknüpfung einige Kanalvergleiche strukturell ungültig machen können.
Hier sehen Sie, wie dieselben rohen Konvertierungszahlen je nach Mapping-Abdeckung unterschiedliche Geschichten erzählen:
| Quelle | Scheinbare Lead-zu-Patient-Rate | Mapping-Abdeckungsrate | Angepasste Interpretation | Empfohlene Maßnahme |
|---|---|---|---|---|
| 14% | 92% | Relativ vertrauenswürdig | Abdeckung überwachen, normal interpretieren | |
| Meta | 15% | 84% | Wahrscheinlich aufgebläht, Nenner fehlen 16 % der Leads | Verknüpfung prüfen, bevor Ausgaben optimiert werden |
| Organisch | 18% | 95% | Hohes Vertrauen | Als Benchmark-Quelle nutzen |
| Empfehlung | 12% | 88% | Mäßiges Vertrauen, auf Lücken bei der Aufnahme-Übergabe prüfen | Nicht zugeordnete Datensätze abgleichen, bevor mit anderen Kanälen verglichen wird |
Ohne die Prüfung des Vertrauens in Healthcare-Analytics-Daten auf Quellenebene vergleichen Sie Zahlen, die nicht auf demselben Fundament stehen.
Was veraltete Lifecycle-Daten für Dashboard-Entscheidungen bedeuten
Die zweite Vertrauensmetrik ist status_freshness_p95_hours: das 95. Perzentil der Verzögerung zwischen einer Lifecycle-Statusaktualisierung im Quellsystem und dem Moment, in dem die Berichtsebene sie auswertet. Das p95 ist wichtiger als der Durchschnitt, da es die Verzögerung im schlimmsten Regelfall zeigt. 95 % der Datensätze liegen bei oder unter dieser Verzögerung, während 5 % langsamer sind.
Die Lifecycle-Status, die in Konvertierungs-KPIs einfließen, umfassen lead_created, became_patient und service_started. Dies sind die kommerziellen Fortschrittsmarker, die Dashboards nützlich machen.
Wenn status_freshness_p95_hours 52 Stunden erreicht, betrachtet eine Klinik, die am Freitag das Dashboard prüft, möglicherweise die Patientendaten vom Mittwoch, während sie Personalentscheidungen für die Aufnahme am Donnerstag trifft. In der IVF, wo das Follow-up und die Terminplanung für Beratungsgespräche davon abhängen, den aktuellen Pipeline-Status zu kennen, führen veraltete Daten zu Entscheidungen, die auf eine Pipeline kalibriert sind, die so nicht mehr existiert.
Ein praktischer Schwellenwert für Dashboard-Vertrauensmetriken liegt bei 48 Stunden. Oberhalb dieser Linie sollten Lifecycle-abhängige KPIs als wenig vertrauenswürdig gekennzeichnet werden, bis die Aktualität wiederhergestellt ist.
Aufbau einer Vertrauensebene: KPI, Schwellenwert, Verantwortlicher, Maßnahme
Jeder Konvertierungs-KPI auf einem Management-Dashboard sollte von einer Datenqualitätskontrolle begleitet werden, die qualifiziert, ob die Interpretation dieses KPIs derzeit sicher ist. Die Vertrauensebene folgt einer vierteiligen Struktur: was gemessen wird, der Schwellenwert, ab dem sich das Vertrauen ändert, wer die Überwachung verantwortet und was passiert, wenn der Schwellenwert überschritten wird.
| KPI | Schwellenwert | Vertrauenssignal | Verantwortlicher | Maßnahme bei Verstoß |
|---|---|---|---|---|
| mapping_coverage_rate | Unter 92% | Mittel | Data/Ops Lead | Quellenverknüpfung nach Kanal prüfen |
| status_freshness_p95_hours | Über 48h | Niedrig | CRM/EMR-Administrator | Quellensynchronisierung prüfen, Lifecycle-abhängige Entscheidungen pausieren |
| Paritätsabgleich-Kontrolle | Jede wesentliche Diskrepanz zwischen CRM-Zahl und Berichtsebene-Zahl | Niedrig | Analytics Lead | Abgleich vor dem nächsten Berichtszyklus |
Entscheidungsvertrauen ist ein synthetisches Signal, keine einzelne Metrik. Es ist eine zusammengesetzte Bewertung, ob Mapping-Abdeckung und Status-Aktualität zusammen die Konvertierungs-KPIs sicher für Maßnahmen machen. Datenvertrauens-KPIs benötigen benannte Verantwortliche und dokumentierte Reaktionsverfahren. Ohne Verantwortlichkeit existieren sie zwar in einem Diagramm, lösen aber keine Handlung aus.
Die Unterscheidung ist einfach: Analytics für Präsentationszwecke zeigen, was die Zahlen sagen. Analytics für Entscheidungsprozesse zeigen zusätzlich, ob man diesen Zahlen gerade vertrauen kann.
Checkliste für Vertrauens-Governance
Nutzen Sie dies als Bereitschaftsprüfung für Ihre IVF-Analytics-Ebene. Dies ist kein technisches Audit. Jeder Operations- oder Analytics-Lead kann dies ohne Unterstützung durch das Engineering ausfüllen.
Zeigt Ihr Dashboard die
mapping_coverage_rateneben den Konvertierungs-KPIs an?Gibt es einen definierten Schwellenwert für die Mapping-Abdeckung, unter dem die Konvertierungsansicht als unzuverlässig gekennzeichnet wird?
Zeigt Ihr Dashboard
status_freshness_p95_hoursals sichtbare Metrik an, nicht nur als Hintergrundprotokoll?Gibt es einen definierten Aktualitätsschwellenwert (z. B. 48 Stunden), ab dem Lifecycle-abhängige KPIs als wenig vertrauenswürdig behandelt werden?
Gibt es einen benannten Verantwortlichen für jede Datenvertrauensmetrik, der für die Reaktion bei Schwellenwertüberschreitungen zuständig ist?
Gibt es ein dokumentiertes Aktionsprotokoll für den Fall einer Schwellenwertüberschreitung – nicht nur eine Warnung, sondern einen definierten Reaktionsschritt?
Werden die Mapping-Abdeckungsraten auf Kanalebene separat verfolgt, sodass Kanalvergleiche nur zwischen vergleichbar verknüpften Datensätzen durchgeführt werden?
Enthalten Ihre Management-Reviews eine Zusammenfassung des Datenvertrauensstatus, bevor Konvertierungs-KPIs besprochen werden?
Wenn Sie weniger als fünf Punkte abgehakt haben, ist Ihr Dashboard möglicherweise nur für Präsentationszwecke geeignet. Es sieht sauber aus, kann Ihnen aber nicht sagen, ob seine eigenen Zahlen zuverlässig genug sind, um darauf basierend zu handeln.
Fazit
IVF-Datenqualitätsmetriken sind kein zweitrangiges Thema, das über das Konvertierungs-Reporting gestülpt wird. Sie sind das strukturelle Fundament, das bestimmt, ob das Konvertierungs-Reporting überhaupt eine Bedeutung hat. Ein Dashboard ohne mapping_coverage_rate und status_freshness_p95_hours kann zwar Diagramme und Trendlinien erzeugen. Es kann Ihnen nur nicht sagen, ob diese Diagramme die Realität genau genug widerspiegeln, um eine Personalentscheidung zu treffen oder ein Kanalbudget zu verschieben.
Die Lösung ist kein Neubau des Data Warehouse. Es ist eine Governance-Entscheidung: Fügen Sie zwei Metriken hinzu, legen Sie Schwellenwerte fest, benennen Sie Verantwortliche und dokumentieren Sie, was passiert, wenn das Vertrauen sinkt. Das ist der Unterschied zwischen Analytics, die man präsentiert, und Analytics, mit denen man arbeitet.
Wenn Ihre Management-Dashboards keine Datenqualitäts-KPIs neben den Konvertierungs-KPIs anzeigen, ist dies die Lücke, die zuerst geschlossen werden muss. Irresist baut Vertrauensebenen vom ersten Tag an in IVF-Analytics ein, denn Strategie funktioniert nur, wenn den zugrunde liegenden Daten bei Betriebsgeschwindigkeit vertraut werden kann.
FAQ
Was ist die mapping_coverage_rate und warum ist sie für IVF-Dashboards wichtig?
Die mapping_coverage_rate ist der Anteil der Lead-Datensätze, die erfolgreich mit einem nachgelagerten Lifecycle-Status verknüpft wurden, wie z. B. became_patient oder service_started. Sie wird berechnet als zugeordnete Datensätze geteilt durch die Gesamtzahl der relevanten Datensätze. Wenn die Abdeckung niedrig ist, schrumpft der für Konvertierungsberechnungen verwendete Nenner, was die scheinbare Konvertierungsrate aufbläht und die Performance-Ansicht verzerrt, auf die sich Ihr Team verlässt.
Was misst status_freshness_p95_hours und was ist ein sicherer Schwellenwert?
status_freshness_p95_hours misst das 95. Perzentil der Verzögerung zwischen einer Lifecycle-Statusaktualisierung im Quellsystem und dem Moment, in dem Ihre Berichtsebene sie auswertet. Dies betrifft Status wie lead_created, became_patient und service_started. Ein praktischer Schwellenwert liegt bei 48 Stunden: Darüber hinaus sollten Lifecycle-abhängige KPIs als wenig vertrauenswürdig gekennzeichnet werden, da Ihr Dashboard möglicherweise Pipeline-Daten anzeigt, die zwei oder mehr Tage alt sind.
Wie wirkt sich eine schlechte CRM/EMR-Datenverknüpfung auf das IVF-Konvertierungs-Reporting aus?
Akquisitionsdaten und Lifecycle-Verlaufsdaten befinden sich in getrennten Systemen. Wenn die Zusammenführung zwischen ihnen fehlschlägt, fallen die betroffenen Datensätze komplett aus den Konvertierungsberechnungen heraus. Wenn ein Kanal beispielsweise eine Mapping-Abdeckung von 84 % hat, wird die Lead-zu-Patient-Rate nur auf Basis von 84 % der tatsächlichen Leads berechnet, wodurch dieser Kanal so erscheint, als würde er besser konvertieren, als er es tatsächlich tut. Dies macht kanalübergreifende Vergleiche unzuverlässig, ohne die Abdeckung pro Quelle zu prüfen.
Was ist der Unterschied zwischen Analytics für Präsentationszwecke und Analytics für Entscheidungsprozesse?
Beide können auf dem Bildschirm identisch aussehen. Dieselben Diagramme, dieselben Zahlen, dieselbe Formatierung. Der Unterschied besteht darin, dass entscheidungsrelevante Analytics Vertrauenskontrollen wie Mapping-Abdeckung und Status-Aktualität enthalten, die Ihnen sagen, ob die Zahlen derzeit zuverlässig genug sind, um darauf basierend zu handeln. Analytics für Präsentationszwecke zeigen, was die Daten sagen. Analytics für Entscheidungsprozesse zeigen zusätzlich, ob Sie ihnen gerade glauben sollten.
Kann ein kleines IVF-Klinikteam eine Vertrauensebene ohne ein dediziertes Data-Engineering-Team implementieren?
Ja. Die Vertrauensebene ist ein operativer Governance-Rahmen, kein technisches Konstrukt. Der praktische Einstieg besteht darin, einen Verantwortlichen für jede Datenvertrauensmetrik zu benennen, Schwellenwerte für das Sinken des Vertrauens festzulegen und mapping_coverage_rate sowie status_freshness_p95_hours zu Ihrem bestehenden Dashboard hinzuzufügen. Die meisten Klinikteams können diese Schritte mit ihren aktuellen Tools und Workflows umsetzen.