Métricas de calidad de datos de FIV: Por qué sus KPI de conversión necesitan una capa de confianza
El análisis de FIV de grado de decisión requiere una capa de confianza que combine los KPI de conversión con métricas específicas de calidad de datos para garantizar que el modelo subyacente sea fiable para las elecciones operativas. Este marco se basa en el monitoreo de las tasas de cobertura de mapeo para evitar la distorsión del denominador y en el seguimiento de la actualización del estado para asegurar que las decisiones del proceso se basen en la progresión actual del paciente en lugar de en información desactualizada.
#4 | Irresist IVF Insights
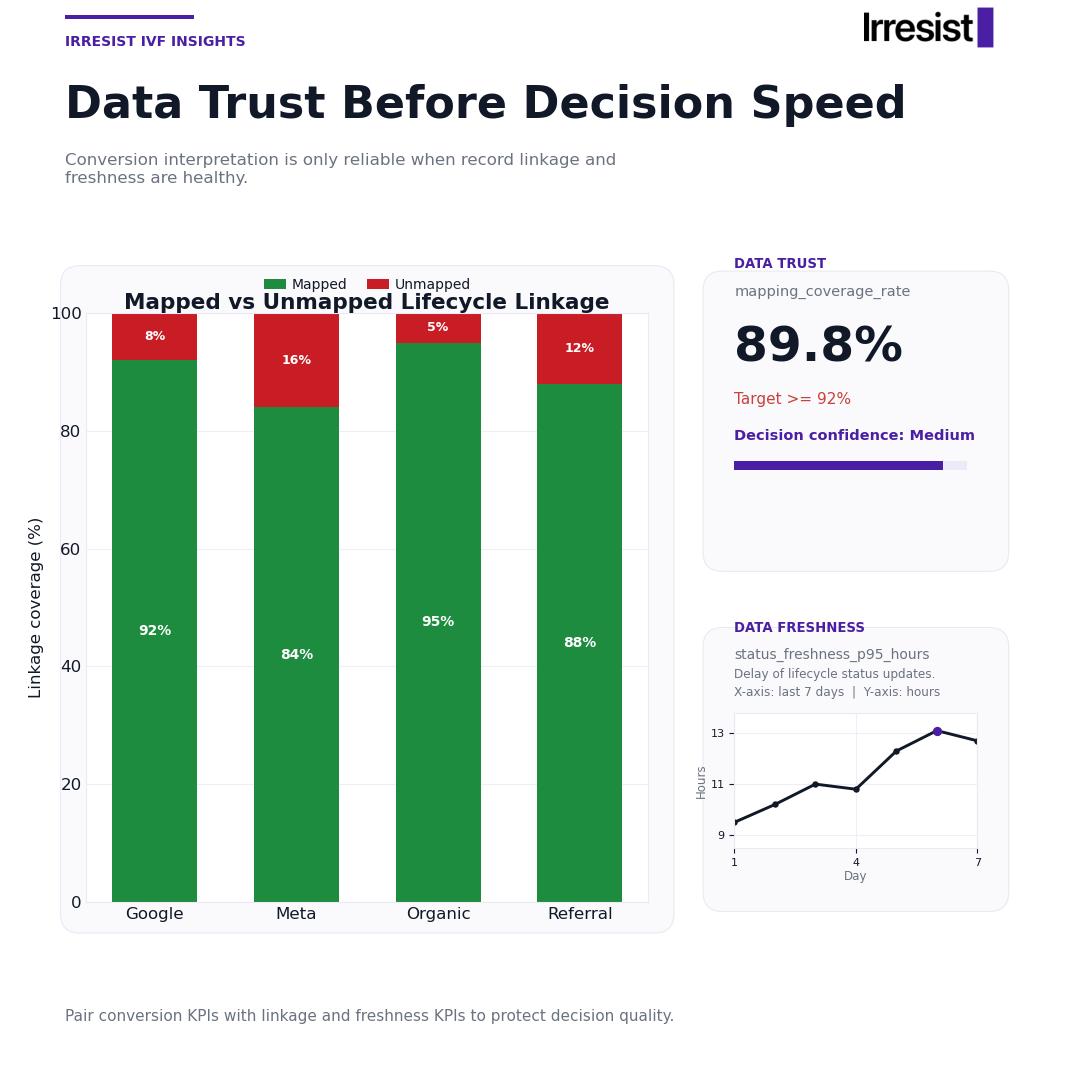
Imagine un panel de control de una clínica donde la conversión de prospecto a paciente parece sólida en todos los canales. Se aprueban los presupuestos, la dotación de personal se mantiene estable y la dirección pasa al siguiente punto del orden del día. Excepto que el 16% de los prospectos de Meta nunca se vincularon a un estado del ciclo de vida posterior, por lo que la tasa de conversión sobre la que todos acaban de actuar se calculó sobre un denominador incompleto. Nadie en la sala tenía forma de saberlo.
Este es el problema central de las métricas de calidad de datos de FIV que carecen de una capa de confianza. Las decisiones sobre presupuesto y personal se toman basándose en tasas de conversión que nadie puede verificar realmente. Los números parecen precisos porque se muestran con decimales y líneas de tendencia, pero la precisión y la fiabilidad no son lo mismo.
Los KPI de conversión y los KPI de confianza en los datos no son categorías separadas. Deben leerse juntos, o el número de conversión se vuelve direccionalmente poco fiable. Este artículo se construye en torno a dos métricas de confianza: mapping_coverage_rate (tasa de cobertura de mapeo) y status_freshness_p95_hours (frescura de estado p95 en horas). Juntas, trazan la línea entre la analítica de nivel de presentación y la analítica de nivel de decisión. Esa línea no tiene nada que ver con el diseño visual y sí con si se puede confiar en el modelo de datos a velocidad operativa.
Conclusiones clave
Tasa de cobertura de mapeo (Mapping coverage rate) - La proporción de registros de prospectos vinculados con éxito a estados del ciclo de vida posteriores. Cuando la cobertura es débil, el denominador de conversión es incorrecto y el rendimiento parece mejor de lo que es en realidad.
La frescura del estado importa por canal - Diferentes fuentes pueden tener tasas de cobertura muy distintas, lo que significa que comparar canales sin comprobar la calidad de la vinculación es estructuralmente inválido.
Los datos de ciclo de vida obsoletos distorsionan las decisiones - Si el
status_freshness_p95_hourssupera las 48 horas, es posible que esté tomando decisiones de personal y admisión basadas en datos de flujo que ya no reflejan la realidad.La analítica de nivel de decisión requiere controles de confianza - Una capa de confianza empareja cada KPI de conversión con un umbral, un responsable y una acción documentada en caso de incumplimiento.
Esto es gobernanza, no ingeniería - Implementar una capa de confianza significa designar responsables y establecer umbrales, no reconstruir su infraestructura de datos.
Por qué la calidad del mapeo cambia el significado de los números de conversión
Los datos de adquisición (prospectos, canales, fuentes) suelen residir en un sistema. Los datos de progresión del ciclo de vida (became_patient, service_started) residen en el CRM o EMR. El KPI de conversión depende de la unión de estos dos mundos. Cuando esa unión falla para un subconjunto de registros, esos registros se vuelven invisibles para los cálculos de conversión.
Un registro mapeado es aquel que se ha vinculado con éxito a un estado del ciclo de vida posterior. Un registro no mapeado no pudo vincularse de forma fiable y simplemente desaparece del modelo. La métrica que captura esto es mapping_coverage_rate: registros mapeados divididos por el total de registros relevantes.
La distorsión es estructural. Si el 16% de los prospectos de Meta no están mapeados, la tasa de prospecto a paciente para Meta se calcula sobre el 84% de los prospectos reales. El denominador se reduce y la tasa de conversión parece más saludable de lo que es. Peor aún, este problema varía según la fuente, lo que significa que las brechas de vinculación de datos de CRM/EMR pueden hacer que algunas comparaciones de canales sean estructuralmente inválidas.
Así es como los mismos números brutos de conversión cuentan historias diferentes según la cobertura de mapeo:
| Fuente | Tasa aparente prospecto-a-paciente | Tasa de cobertura de mapeo | Interpretación ajustada | Acción recomendada |
|---|---|---|---|---|
| 14% | 92% | Relativamente confiable | Monitorear cobertura, interpretar normalmente | |
| Meta | 15% | 84% | Probablemente inflada, al denominador le falta el 16% de prospectos | Auditar vinculación antes de optimizar gasto |
| Orgánico | 18% | 95% | Alta confianza | Usar como fuente de referencia (benchmark) |
| Referencia | 12% | 88% | Confianza moderada, revisar brechas en el traspaso de admisión | Conciliar registros no mapeados antes de comparar con otros canales |
Sin comprobar la confianza de los datos analíticos de salud a nivel de fuente, está comparando números que no están construidos sobre la misma base.
Qué le hace la frescura de datos obsoleta a las decisiones del panel
La segunda métrica de confianza es status_freshness_p95_hours: el percentil 95 del retraso entre una actualización de estado del ciclo de vida en el sistema de origen y el momento en que la capa de informes lo evalúa. El p95 importa más que el promedio porque muestra el retraso en el peor de los casos comunes. El 95% de los registros están en ese retraso o por debajo, mientras que el 5% son más lentos.
Los estados del ciclo de vida que alimentan los KPI de conversión incluyen lead_created, became_patient y service_started. Estos son los marcadores de progresión comercial que hacen que los paneles sean útiles.
Cuando el status_freshness_p95_hours alcanza las 52 horas, una clínica que revisa el panel del viernes puede estar viendo datos de progresión de pacientes del miércoles mientras toma decisiones de personal de admisión para el jueves. En FIV, donde el seguimiento de admisión y la programación de consultas dependen de conocer el estado actual del flujo, los datos obsoletos producen decisiones calibradas para un flujo que ya no existe.
Un umbral práctico para las métricas de confianza del panel es 48 horas. Por encima de esa línea, los KPI dependientes del ciclo de vida deben marcarse como de baja confianza hasta que se restaure la frescura.
Construyendo una capa de confianza: KPI, umbral, responsable, acción
Cada KPI de conversión en un panel de liderazgo debe ir acompañado del control de calidad de datos que califica si interpretar ese KPI es actualmente seguro. La capa de confianza sigue una estructura de cuatro partes: qué se mide, el umbral donde cambia la confianza, quién supervisa y qué sucede cuando se supera el umbral.
| KPI | Umbral | Señal de confianza | Responsable | Acción por incumplimiento |
|---|---|---|---|---|
| mapping_coverage_rate | Debajo del 92% | Media | Líder de datos/operaciones | Auditar vinculación de origen por canal |
| status_freshness_p95_hours | Sobre 48h | Baja | Administrador de CRM/EMR | Revisar sincronización de origen, pausar decisiones dependientes del ciclo de vida |
| Control de desajuste de paridad | Cualquier discrepancia material entre el conteo del CRM y el de la capa de informes | Baja | Líder de analítica | Conciliación antes del próximo ciclo de informes |
La confianza en la decisión es una señal sintética, no una métrica única. Es una lectura compuesta de si la cobertura de mapeo y la frescura del estado juntas hacen que sea seguro actuar sobre los KPI de conversión. Los KPI de confianza en los datos necesitan responsables designados y procedimientos de respuesta documentados. Sin propiedad, existen en un gráfico pero no activan ninguna acción.
La distinción es sencilla: la analítica de nivel de presentación muestra lo que dicen los números. La analítica de nivel de decisión también muestra si se puede confiar en esos números en este momento.
Lista de verificación de gobernanza de confianza
Use esto como una verificación de preparación para su capa analítica de FIV. Esto no es una auditoría técnica. Cualquier líder de operaciones o analítica puede completarla sin soporte de ingeniería.
¿Muestra su panel el
mapping_coverage_ratejunto a los KPI de conversión?¿Existe un umbral definido para la cobertura de mapeo por debajo del cual la vista de conversión se marca como poco fiable?
¿Muestra su panel el
status_freshness_p95_hourscomo una métrica visible, no como un registro en segundo plano?¿Existe un umbral de frescura definido (como 48 horas) por encima del cual los KPI dependientes del ciclo de vida se tratan como de baja confianza?
¿Hay un responsable designado para cada métrica de confianza de datos que sea responsable de la respuesta ante incumplimientos?
¿Existe un protocolo de acción documentado para cuando se supera un umbral, no solo una alerta, sino un paso de respuesta definido?
¿Se rastrean por separado las tasas de cobertura de mapeo a nivel de canal, de modo que las comparaciones de fuentes solo se realicen entre conjuntos de datos vinculados de manera comparable?
¿Incluyen sus revisiones de liderazgo un resumen del estado de confianza de los datos antes de discutir los KPI de conversión?
Si marcó menos de cinco, su panel puede ser de nivel de presentación. Se ve limpio, pero no puede decirle si sus propios números son lo suficientemente fiables como para actuar sobre ellos.
La conclusión
Las métricas de calidad de datos de FIV no son una preocupación secundaria añadida sobre los informes de conversión. Son la base estructural que determina si los informes de conversión significan algo en absoluto. Un panel sin mapping_coverage_rate y status_freshness_p95_hours aún puede producir gráficos y líneas de tendencia. Simplemente no puede decirle si esos gráficos reflejan la realidad lo suficientemente cerca como para tomar una decisión de personal o cambiar el presupuesto de un canal.
La solución no es una reconstrucción del almacén de datos. Es una decisión de gobernanza: añadir dos métricas, establecer umbrales, designar responsables y documentar qué sucede cuando cae la confianza. Esa es la diferencia entre la analítica que presenta y la analítica con la que opera.
Si sus paneles de liderazgo no muestran KPI de calidad de datos junto a los KPI de conversión, esa es la brecha que debe cerrar primero. Irresist integra capas de confianza en la analítica de FIV desde el primer día porque la estrategia solo funciona cuando se puede confiar en los datos subyacentes a velocidad operativa.
Preguntas frecuentes
¿Qué es mapping_coverage_rate y por qué es importante para los paneles de FIV?
mapping_coverage_rate es la proporción de registros de prospectos vinculados con éxito a un estado del ciclo de vida posterior, como became_patient o service_started. Se calcula como registros mapeados divididos por el total de registros relevantes. Cuando la cobertura es baja, el denominador utilizado para los cálculos de conversión se reduce, lo que infla la tasa de conversión aparente y distorsiona la visión del rendimiento en la que confía su equipo.
¿Qué mide status_freshness_p95_hours y cuál es un umbral seguro?
status_freshness_p95_hours mide el percentil 95 del retraso entre una actualización de estado del ciclo de vida en el sistema de origen y el momento en que su capa de informes lo evalúa. Afecta a estados como lead_created, became_patient y service_started. Un umbral práctico es 48 horas: por encima de eso, los KPI dependientes del ciclo de vida deben marcarse como de baja confianza porque su panel puede estar mostrando datos de flujo que tienen dos o más días de antigüedad.
¿Cómo afecta una vinculación deficiente de datos CRM/EMR a los informes de conversión de FIV?
Los datos de adquisición y los datos de progresión del ciclo de vida residen en sistemas separados. Cuando la unión entre ellos falla, los registros afectados desaparecen por completo de los cálculos de conversión. Por ejemplo, si un canal tiene una cobertura de mapeo del 84%, la tasa de prospecto a paciente se calcula sobre solo el 84% de los prospectos reales, haciendo que ese canal parezca convertir mejor de lo que lo hace. Esto hace que las comparaciones entre canales no sean fiables sin comprobar la cobertura por fuente.
¿Cuál es la diferencia entre la analítica de nivel de presentación y la de nivel de decisión?
Ambas pueden parecer idénticas en pantalla. Mismos gráficos, mismos números, mismo formato. La diferencia es que la analítica de nivel de decisión incluye controles de confianza, como la cobertura de mapeo y la frescura del estado, que le indican si los números son actualmente lo suficientemente fiables como para actuar sobre ellos. La analítica de nivel de presentación muestra lo que dicen los datos. La analítica de nivel de decisión también muestra si debe creerlo en este momento.
¿Puede un equipo pequeño de una clínica de FIV implementar una capa de confianza sin un equipo dedicado de ingeniería de datos?
Sí. La capa de confianza es un marco de gobernanza operativa, no una construcción técnica. El punto de entrada práctico es designar un responsable para cada métrica de confianza de datos, establecer umbrales para cuando la confianza cae y añadir mapping_coverage_rate y status_freshness_p95_hours a su panel actual. La mayoría de los equipos de clínicas pueden comenzar con estos pasos utilizando sus herramientas y flujos de trabajo actuales.