Métricas de Qualidade de Dados de FIV: Por que seus KPIs de Conversão Precisam de uma Camada de Confiança
As análises de fertilização in vitro de nível de decisão exigem uma camada de confiança que combine KPIs de conversão com métricas específicas de qualidade de dados para garantir que o modelo subjacente seja confiável para escolhas operacionais. Esse framework baseia-se no monitoramento das taxas de cobertura de mapeamento para evitar a distorção do denominador e no acompanhamento da atualização do status para garantir que as decisões de pipeline sejam baseadas na progressão atual do paciente, em vez de informações obsoletas.
#4 | Irresist IVF Insights
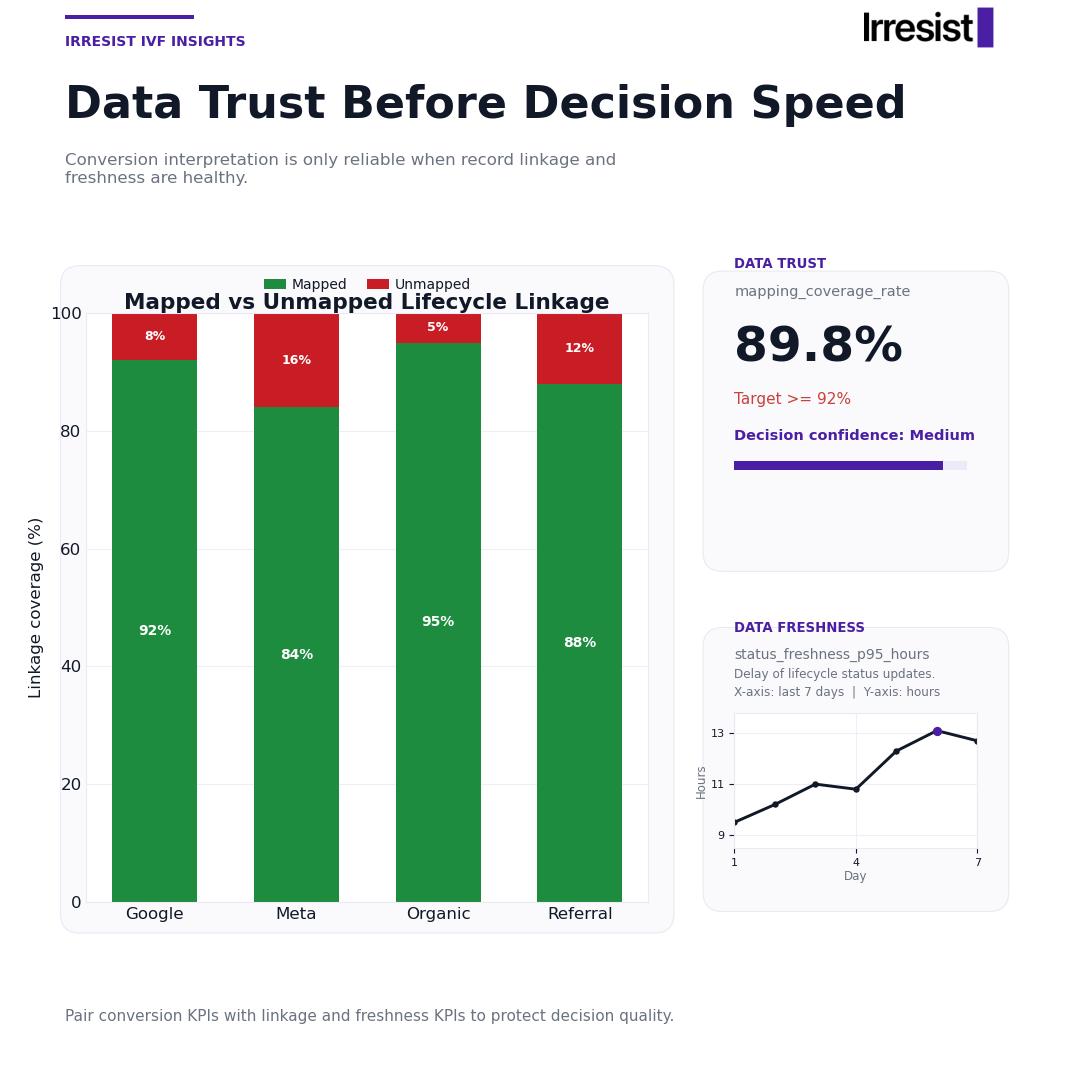
Imagine um painel de controle de uma clínica onde a conversão de leads em pacientes parece sólida em todos os canais. Os orçamentos são aprovados, o quadro de funcionários permanece estável e a liderança passa para o próximo item da pauta. Exceto que 16% dos leads do Meta nunca foram vinculados a um estado de ciclo de vida posterior, portanto, a taxa de conversão sobre a qual todos acabaram de agir foi calculada com base em um denominador incompleto. Ninguém na sala tinha como saber.
Este é o problema central com as métricas de qualidade de dados de FIV que carecem de uma camada de confiança. Decisões de orçamento e pessoal são tomadas com base em taxas de conversão que ninguém pode realmente verificar. Os números parecem precisos porque são exibidos com casas decimais e linhas de tendência, mas precisão e confiabilidade não são a mesma coisa.
KPIs de conversão e KPIs de confiança nos dados não são categorias separadas. Eles devem ser lidos juntos, ou o número de conversão torna-se direcionalmente não confiável. Este artigo baseia-se em duas métricas de confiança: mapping_coverage_rate (taxa de cobertura de mapeamento) e status_freshness_p95_hours (atualização de status p95 em horas). Juntas, elas traçam a linha entre análises de nível de apresentação e análises de nível de decisão. Essa linha não tem nada a ver com design visual e tudo a ver com o fato de o modelo de dados ser confiável na velocidade operacional.
Principais conclusões
Taxa de cobertura de mapeamento (Mapping coverage rate) - A parcela de registros de leads vinculados com sucesso aos estados do ciclo de vida posteriores. Quando a cobertura é fraca, seu denominador de conversão está errado e o desempenho parece melhor do que a realidade.
A atualização do status importa por canal - Diferentes fontes podem ter taxas de cobertura muito diferentes, o que significa que comparar canais sem verificar a qualidade da vinculação é estruturalmente inválido.
Dados de ciclo de vida obsoletos distorcem decisões - Se o
status_freshness_p95_hoursexceder 48 horas, você pode estar tomando decisões de pessoal e admissão com base em dados de pipeline que não refletem mais a realidade.Análises de nível de decisão exigem controles de confiança - Uma camada de confiança combina cada KPI de conversão com um limite, um proprietário e uma ação de violação documentada.
Isso é governança, não engenharia - Implementar uma camada de confiança significa nomear proprietários e definir limites, não reconstruir sua infraestrutura de dados.
Por que a qualidade do mapeamento altera o significado dos números de conversão
Os dados de aquisição (leads, canais, fontes) normalmente residem em um sistema. Os dados de progressão do ciclo de vida (became_patient, service_started) residem no CRM ou prontuário eletrônico (EMR). O KPI de conversão depende da união desses dois mundos. Quando essa união falha para um subconjunto de registros, esses registros tornam-se invisíveis para os cálculos de conversão.
Um registro mapeado é aquele vinculado com sucesso a um estado de ciclo de vida posterior. Um registro não mapeado não pôde ser vinculado de forma confiável e simplesmente desaparece do modelo. A métrica que captura isso é a mapping_coverage_rate: registros mapeados divididos pelo total de registros relevantes.
A distorção é estrutural. Se 16% dos leads do Meta não estão mapeados, a taxa de lead para paciente do Meta é calculada sobre 84% dos leads reais. O denominador encolhe e a taxa de conversão parece mais saudável do que realmente é. Pior ainda, esse problema varia por fonte, o que significa que lacunas de vinculação de dados de CRM/EMR podem tornar algumas comparações de canais estruturalmente inválidas.
Veja como os mesmos números brutos de conversão contam histórias diferentes dependendo da cobertura de mapeamento:
| Fonte | Taxa aparente lead-para-paciente | Taxa de cobertura de mapeamento | Interpretação ajustada | Ação recomendada |
|---|---|---|---|---|
| 14% | 92% | Relativamente confiável | Monitorar cobertura, interpretar normalmente | |
| Meta | 15% | 84% | Provavelmente inflada, o denominador carece de 16% dos leads | Auditar vinculação antes de otimizar gastos |
| Orgânico | 18% | 95% | Alta confiança | Usar como fonte de referência (benchmark) |
| Indicação | 12% | 88% | Confiança moderada, verificar lacunas na passagem de admissão | Reconciliar registros não mapeados antes de comparar com outros canais |
Sem verificar a confiança dos dados de análise de saúde no nível da fonte, você está comparando números que não foram construídos sobre a mesma base.
O que dados de ciclo de vida obsoletos fazem com as decisões do painel
A segunda métrica de confiança é status_freshness_p95_hours: o 95º percentil de atraso entre uma atualização de status de ciclo de vida no sistema de origem e o momento em que a camada de relatório a avalia. O p95 importa mais do que a média porque mostra o atraso no pior caso comum. 95% dos registros estão no nível ou abaixo desse atraso, enquanto 5% são mais lentos.
Os estados do ciclo de vida que alimentam os KPIs de conversão incluem lead_created, became_patient e service_started. Estes são os marcadores de progressão comercial que tornam os painéis úteis.
Quando o status_freshness_p95_hours atinge 52 horas, uma clínica que revisa o painel de sexta-feira pode estar olhando para os dados de progressão de pacientes de quarta-feira enquanto toma decisões de pessoal de admissão para quinta-feira. Na FIV, onde o acompanhamento da admissão e o agendamento de consultas dependem do conhecimento do estado atual do pipeline, dados obsoletos produzem decisões calibradas para um pipeline que não existe mais.
Um limite prático para métricas de confiança do painel é 48 horas. Acima dessa linha, os KPIs dependentes do ciclo de vida devem ser sinalizados como de baixa confiança até que a atualização seja restaurada.
Construindo uma camada de confiança: KPI, limite, proprietário, ação
Cada KPI de conversão em um painel de liderança deve ser acompanhado pelo controle de qualidade de dados que qualifica se a interpretação desse KPI é segura no momento. A camada de confiança segue uma estrutura de quatro partes: o que é medido, o limite onde a confiança muda, quem monitora e o que acontece quando o limite é violado.
| KPI | Limite | Sinal de confiança | Proprietário | Ação de violação |
|---|---|---|---|---|
| mapping_coverage_rate | Abaixo de 92% | Médio | Líder de Dados/Ops | Auditar vinculação de origem por canal |
| status_freshness_p95_hours | Acima de 48h | Baixo | Administrador de CRM/EMR | Verificar sincronização de origem, pausar decisões dependentes do ciclo de vida |
| Controle de paridade | Qualquer discrepância material entre a contagem do CRM e a camada de relatório | Baixo | Líder de Analytics | Reconciliação antes do próximo ciclo de relatórios |
A confiança na decisão é um sinal sintético, não uma métrica única. É uma leitura composta de se a cobertura de mapeamento e a atualização do status juntas tornam os KPIs de conversão seguros para agir. Os KPIs de confiança nos dados precisam de proprietários nomeados e procedimentos de resposta documentados. Sem propriedade, eles existem em um gráfico, mas não desencadeiam nenhuma ação.
A distinção é direta: as análises de nível de apresentação mostram o que os números dizem. As análises de nível de decisão também mostram se esses números podem ser confiáveis agora.
Checklist de governança de confiança
Use isto como uma verificação de prontidão para sua camada de análise de FIV. Esta não é uma auditoria técnica. Qualquer líder de operações ou análise pode completá-la sem suporte de engenharia.
Seu painel exibe a
mapping_coverage_rateao lado dos KPIs de conversão?Existe um limite definido para a cobertura de mapeamento abaixo do qual a visualização de conversão é sinalizada como não confiável?
Seu painel exibe
status_freshness_p95_hourscomo uma métrica visível, não apenas um log de fundo?Existe um limite de atualização definido (como 48 horas) acima do qual os KPIs dependentes do ciclo de vida são tratados como de baixa confiança?
Existe um proprietário nomeado para cada métrica de confiança de dados que seja responsável pela resposta à violação?
Existe um protocolo de ação documentado para quando um limite é violado — não apenas um alerta, mas uma etapa de resposta definida?
As taxas de cobertura de mapeamento no nível do canal são rastreadas separadamente, para que as comparações de fontes sejam feitas apenas entre conjuntos de dados vinculados de forma comparável?
Suas revisões de liderança incluem um resumo do status de confiança dos dados antes que os KPIs de conversão sejam discutidos?
Se você marcou menos de cinco, seu painel pode ser de nível de apresentação. Ele parece limpo, mas não pode dizer se seus próprios números são confiáveis o suficiente para agir.
A conclusão
As métricas de qualidade de dados de FIV não são uma preocupação secundária sobreposta aos relatórios de conversão. Elas são a base estrutural que determina se os relatórios de conversão significam alguma coisa. Um painel sem mapping_coverage_rate e status_freshness_p95_hours ainda pode produzir gráficos e linhas de tendência. Ele apenas não pode dizer se esses gráficos refletem a realidade de perto o suficiente para tomar uma decisão de contratação ou mudar o orçamento de um canal.
A solução não é uma reconstrução do data warehouse. É uma decisão de governança: adicionar duas métricas, definir limites, nomear proprietários e documentar o que acontece quando a confiança cai. Essa é a diferença entre as análises que você apresenta e as análises com as quais você opera.
Se os seus painéis de liderança não mostram KPIs de qualidade de dados ao lado dos KPIs de conversão, essa é a lacuna a ser fechada primeiro. A Irresist constrói camadas de confiança nas análises de FIV desde o primeiro dia porque a estratégia só funciona quando os dados subjacentes podem ser confiáveis na velocidade operacional.
FAQ
O que é mapping_coverage_rate e por que ela importa para os painéis de FIV?
A mapping_coverage_rate é a parcela de registros de leads vinculados com sucesso a um estado de ciclo de vida posterior, como became_patient ou service_started. É calculada como registros mapeados divididos pelo total de registros relevantes. Quando a cobertura é baixa, o denominador usado para os cálculos de conversão encolhe, o que infla a taxa de conversão aparente e distorce a visão de desempenho na qual sua equipe confia.
O que o status_freshness_p95_hours mede e qual é um limite seguro?
O status_freshness_p95_hours mede o 95º percentil de atraso entre uma atualização de status de ciclo de vida no sistema de origem e o momento em que sua camada de relatório a avalia. Afeta estados como lead_created, became_patient e service_started. Um limite prático é de 48 horas: acima disso, os KPIs dependentes do ciclo de vida devem ser sinalizados como de baixa confiança porque seu painel pode estar mostrando dados de pipeline com dois ou mais dias de atraso.
Como a má vinculação de dados de CRM/EMR afeta os relatórios de conversão de FIV?
Os dados de aquisição e os dados de progressão do ciclo de vida residem em sistemas separados. Quando a união entre eles falha, os registros afetados saem completamente dos cálculos de conversão. Por exemplo, se um canal tem 84% de cobertura de mapeamento, a taxa de lead para paciente é calculada sobre apenas 84% dos leads reais, fazendo com que esse canal pareça converter melhor do que realmente converte. Isso torna as comparações entre canais não confiáveis sem verificar a cobertura por fonte.
Qual é a diferença entre análises de nível de apresentação e de nível de decisão?
Ambas podem parecer idênticas na tela. Mesmos gráficos, mesmos números, mesma formatação. A diferença é que as análises de nível de decisão incluem controles de confiança, como cobertura de mapeamento e atualização de status, que informam se os números são atualmente confiáveis o suficiente para agir. As análises de nível de apresentação mostram o que os dados dizem. As análises de nível de decisão também mostram se você deve acreditar neles agora.
Uma equipe de clínica de FIV pequena pode implementar uma camada de confiança sem uma equipe dedicada de engenharia de dados?
Sim. A camada de confiança é uma estrutura de governança operacional, não uma construção técnica. O ponto de entrada prático é nomear um proprietário para cada métrica de confiança de dados, definir limites para quando a confiança cai e adicionar mapping_coverage_rate e status_freshness_p95_hours ao seu painel existente. A maioria das equipes de clínicas pode começar com essas etapas usando suas ferramentas e fluxos de trabalho atuais.